



Що ми робимо
-
Сервіси на FastAPI
Типізоване API, за яким сховані виклики моделей, пошук і логіка промптів. Ваш продукт просто його викликає.
-
Конвеєри даних
Парсер на кожен формат джерела, нормалізація в одну схему, дедуплікація й лог кожного запису, що не пройшов.
-
RAG
Розбиття на фрагменти, ембединги, векторний і графовий пошук з перевіркою прав доступу.
-
Інтеграція LLM
OpenAI, Anthropic Claude або відкриті моделі, з версіями промптів, резервними моделями й наборами для оцінювання.
-
Дотренування й інференс
LoRA-адаптери на відкритих моделях, GPU-воркери і vLLM, що підвантажує потрібний адаптер під запит.
-
Фонова обробка
Черги задач, повторні спроби й видимий статус для всього, що триває довше кількох секунд.
Двадцять хвилин між файлом і живою розмовою
Людина завантажує експорт WhatsApp чи резервну копію iPhone і чекає приблизно двадцять хвилин. За цей час система розбирає листування, з'ясовує, хто з двох учасників є тією людиною, яку пам'ятають, пише її профіль від першої особи, збирає набір даних, навчає адаптер і будує граф фактів. Так працює AI Grief Companion, який ми зробили для американського стартапу. Уся ця частина написана на Python.
Шлюз на Python розбирає десять форматів експорту: WhatsApp, Messenger, Instagram, Discord, iMessage з резервної копії iPhone, Android SMS і звичайний текст. Усе зводиться в одну таблицю повідомлень, і кожне повідомлення шифрується одразу під час завантаження. Якщо детектор ролей не впевнений, хто є хто, він зупиняється й питає користувача, а не вгадує: помилка тут означала б модель, навчену на чужих словах. ШІ-платформа над шлюзом працює на FastAPI і Celery з PostgreSQL, Redis і Neo4j. Сім типів задач розходяться між CPU- і GPU-воркерами, а коли власного GPU-сервера бракує, навчання й інференс беруть serverless-воркери RunPod.
Така розробка ШІ на Python і є нашою основною роботою з цією мовою: сервіси на FastAPI навколо мовних моделей, конвеєри, що перетворюють безладні джерела на чисті дані, RAG і дотренування з фоновими воркерами.
Кейси
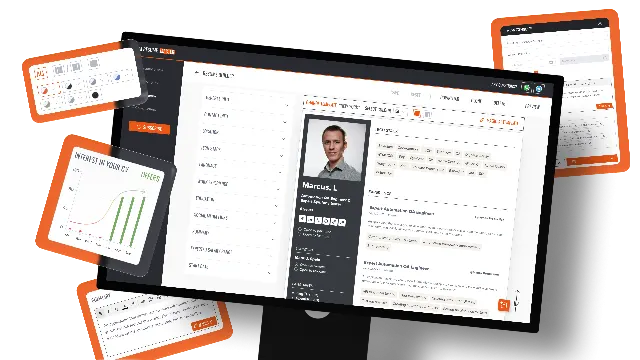
 AI Resume Master: Resume Builder with AI Integration
AI Resume Master case study: an AI resume builder with LLM writing, LinkedIn import and PDF export, built in three months and now at 50,000 monthly users. Переглянути кейс
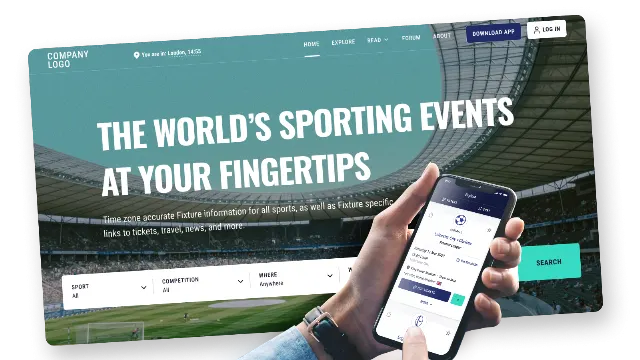
 Smart Sports Event Discovery Platform
Case study: sports event calendar for a UK company that aggregates fixtures from hundreds of calendars and feeds, with APIs and embeddable widgets. Переглянути кейс
Python для ШІ й даних, решта продукту на своєму місці
Вебпродукти ми зазвичай будуємо на PHP/Symfony або Node.js з React. Python додаємо туди, де цього вимагає робота з ШІ, машинним навчанням чи великими обсягами даних, бо саме там його екосистема найсильніша. Облікові записи, оплати, адмінка й бізнес-правила часто краще почуваються в основному бекенді, і багато наших продуктів використовують обидві мови.
| Задача | Де ми зазвичай її реалізуємо | Чому |
|---|---|---|
| Виклики OpenAI чи Claude, потокова передача відповідей | Ваш наявний бекенд (PHP або Node.js) | Новий сервіс не потрібен |
| Завантаження й нормалізація багатьох форматів документів чи даних | Python-сервіс | Зрілі бібліотеки для парсингу й роботи з даними |
| RAG над великими або часто змінюваними даними | Python-сервіс | Інструменти для ембедингів, пошуку й оцінювання |
| Дотренування, навчання LoRA, інференс відкритих моделей | Python з GPU-воркерами | Екосистема ML живе в Python |
| Облікові записи, оплати, ролі, адмін-панелі | PHP/Symfony або Node.js | Зрілі інструменти для продукту й адмінки |
Саме за цим поділом зроблено наш власний AI Resume Master: PHP і Symfony тримають продукт, React відповідає за інтерфейс, Python з LLM генерує резюме й супровідні листи. Продукт вийшов на 50 000 активних користувачів на місяць.
Чи можна додати Python-сервіс до продукту на PHP або Node.js?
Так, і саме так ми найчастіше використовуємо Python. Ваш продукт зберігає свій бекенд, облікові записи й оплати. Окремий Python-сервіс займається ШІ чи даними і надає невелике типізоване API. Основний бекенд викликає його з контекстом користувача, а тривалі задачі звітують через колбек або ендпоінт статусу. Права доступу лишаються в основному бекенді, тож Python-сервіс сам ніколи не вирішує, хто що бачить.
Ризик при цьому низький. Новий сервіс розгортається, масштабується й відкочується окремо, а решта продукту не міняє ні мову, ні фреймворк. Інший бік інтеграції описано на сторінках розробка на PHP і розробка на Node.js.
Сервіс на FastAPI: наші правила
Розробка на FastAPI в нас дає невелике типізоване API, яке ховає від решти продукту виклики моделей, пошук і логіку промптів. Продукт ставить запитання або надсилає задачу. Сервіс сам вирішує, яку модель і які дані взяти, і повертає результат у фіксованому форматі. Ми тримаємося шести правил:
- Типізовані контракти для кожного запиту й відповіді, документація OpenAPI генерується з них.
- Промпти зберігаються як дані, з версіями. В AI Grief Companion вони лежать у PostgreSQL з історією змін, і тон можна підправити з адмінки без релізу.
- Задачі замість довгих запитів. Усе, що триває довше кількох секунд, іде у фонові воркери зі статусом, який продукт опитує або отримує через колбек.
- Резервні моделі й тайм-аути, щоб один повільний провайдер не зупиняв продукт.
- Набори для оцінювання в CI: зміну промпту чи моделі вимірюємо до релізу.
- Логи вхідних даних, результатів і витрат токенів. З чутливими даними працюємо за вашими правилами.
Спершу чисті дані, потім чат
Більшість проблем із пошуком виникає через дані, які ніхто не чистив: дублікати, зламане форматування, відсутні власники, змішані мови. Тому розробка RAG на Python у нас починається з конвеєра, а чат з'являється пізніше.
Конвеєр складається з парсера на кожен формат джерела, нормалізації в одну схему, дедуплікації й валідації. Далі розбиття на фрагменти за структурою документа, ембединги та індекс, а наприкінці пошук з перевіркою доступу, щоб користувач бачив лише дозволене. Кожен крок пише в лог, що він обробив і що не вдалося. В AI Grief Companion пам'ять будують три рівні пошуку над графом фактів у Neo4j, і вони змагаються за п'ять місць у промпті. Детальніше на сторінці розробка RAG і в нашому посібнику з впровадження RAG.
Розробка конвеєрів даних потрібна не лише для ШІ. Календар спортивних подій для британської sports tech компанії побудований на PHP і Python і має власний рушій парсингу. Він збирає й нормалізує розклади матчів із сотень календарів і фідів, враховує часові пояси і віддає дані B2B-клієнтам через API та вбудовувані віджети. А для B2B-магазину верстатів із Дніпра Python обробляв дані каталогу й прибирав водяні знаки зі старих фото товарів для фіду Google Shopping.
Коли дотренування має сенс?
Коли модель мусить тримати певний голос, формат чи поведінку, яких промпти й RAG надійно не втримують. Для більшості бізнесових продуктів промпти плюс пошук по ваших даних дають більше, коштують менше і простіше оновлюються, коли дані змінюються.
Якщо дотренування все ж потрібне, беремо параметрично ефективні методи на кшталт LoRA на відкритій моделі, набір даних з ваших даних і набір для оцінювання, щоб виміряти результат. В AI Grief Companion конвеєр навчає LoRA-адаптери на Qwen2.5-7B з 4-бітним QLoRA, а vLLM для кожного запиту підвантажує потрібний адаптер. Інференс навмисно має запасний режим: чат працює з базовою моделлю вже за кілька хвилин після завантаження і стає ближчим до людини з кожним завершеним етапом навчання. Про вибір моделей читайте на сторінці розробка генеративного ШІ.
Якщо ми хочемо, щоб бот справді спілкувався з людьми, йому треба дати базу знань про вашу компанію. Це не складно, її просто треба підготувати, а далі поповнювати в автоматичному режимі.
Антон Литвинов, засновник Lytvynov Production
Скільки коштує розробка на Python?
Ціна залежить від обсягу даних, стратегії щодо моделей і того, як сервіс підключається до вашого продукту. Для орієнтиру: ШІ-функція на хмарних моделях у нас коштує від 10 000 USD, ШІ-застосунок над даними компанії з RAG від 10 000 до 40 000 USD, продукт із власними моделями (дотренування, RAG-пам'ять, інференс на GPU, конвеєри даних) від 60 000 до 150 000 USD. Токени, векторні сховища й GPU під час роботи оплачуються окремо. Як їх порахувати, пояснюємо в посібнику про вартість розробки ШІ-застосунку.
Як ми працюємо
Як компанія з розробки на Python ми починаємо з короткої розмови про продукт, дані й те, що має робити ШІ, а потім погоджуємо перший етап із фіксованою ціною. Для ШІ-проєктів він зазвичай включає набір для оцінювання, тож якість вимірюється з першого тижня. Далі етапи з демо щотижня, у ваших репозиторіях і хмарних акаунтах. Наші Python-розробники рівня senior перевіряють кожну зміну, а рутину на кшталт тестів і рефакторингу беруть ШІ-агенти для написання коду. Хочете найняти Python-розробників у свою команду на довший строк? Це теж можливо, з помісячною оплатою.
Підключення ШІ до наявного продукту описане на сторінці інтеграція ШІ. Розгортання й моніторинг Python-сервісів беремо на себе, детальніше на сторінках DevOps на Docker і Kubernetes і розробка на AWS.
Розкажіть про ваш ШІ-проєкт чи проєкт із даними на сторінці контактів або опишіть обсяг у формі оцінки проєкту.
Як ми працюємо
-
Коротка розмова
Говоримо про продукт, дані й те, що має робити ШІ.
-
Фіксована ціна етапу
Погоджуємо перший етап із фіксованою ціною. Для ШІ-проєктів він включає набір для оцінювання.
-
Демо щотижня
Робота йде етапами у ваших репозиторіях і хмарних акаунтах.
-
Сеньйорний перегляд
Сеньйорні інженери перевіряють кожну зміну, ШІ-агенти беруть рутину: тести й рефакторинг.
-
Розгортання
Python-сервіс розгортається, масштабується й відкочується окремо від решти продукту.
Два способи працювати з нами
Проєкт з фіксованою ціною
Чіткий обсяг, фіксована ціна, погоджена до старту і демо щотижня. Підходить для нового продукту або зрозумілої частини роботи.
Оцінити проєктВиділена команда
Senior-інженери, які місяць за місяцем працюють лише над вашим продуктом, за вашими пріоритетами і у ваших репозиторіях.
Про виділену команду