



Що ми робимо
-
Функція на Claude у продукті
Чернетки, підсумки, витягування даних, класифікація чи відповіді за вашими даними, з викликом моделі лише з вашого сервера.
-
Tool use і MCP
Claude викликає ваші функції з типізованими даними і правами поточного користувача, а спільні інструменти живуть в MCP-сервері.
-
Довгі документи
Договори, звіти, розшифровки й кодові бази в одному запиті, а коли треба, пошук по даних (RAG) з посиланнями на джерела.
-
Контроль витрат
Кешування промптів, маршрутизація між рівнями моделей, пакетні завдання і жорсткі ліміти на користувача та функцію.
-
Оцінювання якості
Фіксований набір реальних прикладів запускається при кожній зміні промпту чи моделі, тож регресія видна до релізу.
Claude вже допомагає вашій команді. Тепер він потрібен у продукті
Зазвичай розмова починається так: команда давно користується Claude в чаті, бачить, як він читає довгі документи і тримається інструкцій, і хоче того самого всередині власного продукту. Щоб менеджер не копіював договір у чат, а система сама витягувала з нього потрібні пункти. Щоб підтримка отримувала чернетку відповіді за вашими правилами тону. Щоб асистент міг знайти замовлення клієнта, а не лише розповісти, як його шукати.
Інтеграція Claude у продукт означає, що модель викликається з вашого сервера, ніколи з браузера. Ключі, промпти, ліміти запитів і логи лишаються під вашим контролем. А сама функція стає звичайною частиною продукту: з правами доступу, тестами й обліком витрат.
Один виклик API з цього нічого не робить. Роботу забирає все інше: вибір рівня моделі за вимірами на ваших прикладах, промпти, які живуть у коді й проходять рев'ю як код, виклик ваших функцій з типізованими даними, структуровані відповіді з перевіркою за схемою, потоковий інтерфейс і ліміти витрат з першого дня. Якщо ви ще обираєте провайдера, почніть з нашого посібника про інтеграцію ChatGPT або Claude у продукт. Ця сторінка для тих, хто вже обрав Claude або хоче мати його однією з моделей.
Де Claude сильний, а де ми перевіряємо альтернативу
З нашого досвіду, Claude варто тестувати першим, коли вхідні дані довгі: договори, політики, звіти, розшифровки чи кодові бази, які треба читати цілком, а не фрагментами. Велике контекстне вікно дозволяє вмістити багато таких документів в один запит. Він добре тримає детальні інструкції, тобто правила тону, формати відповіді й вимоги відповідності, яких відповідь має дотримуватися щоразу. Він впевнено працює з інструментами в кілька кроків. І пише тексти, які не соромно показати клієнтові.
Але Claude ми за замовчуванням не обираємо. Той самий набір для оцінювання проганяємо на Claude і щонайменше одній альтернативі, часто на моделі OpenAI, і рішення ухвалюємо за виміряною якістю, затримкою і вартістю запиту. Багато продуктів зрештою використовують обидві моделі. Про інший бік є сторінка інтеграція OpenAI API, а порівняння зібрано в посібнику Claude чи OpenAI API.
Можливості Claude API, з якими ми працюємо
| Можливість | Що робить | Де ми її використовуємо |
|---|---|---|
| Messages API | Основний API для діалогів і окремих запитів | У кожній інтеграції |
| Tool use | Claude викликає визначені вами функції з типізованими JSON-даними | Асистенти, що шукають або змінюють дані; агенти |
| Prompt caching | Повторно використовує однакові початки промптів дешевше й швидше | Довгі системні промпти, набори інструментів, довідкові документи |
| Long context | Великі документи в одному запиті | Перевірка договорів, аналіз звітів, запитання по кодовій базі |
| Extended thinking | Довші міркування перед відповіддю на моделях, що це підтримують | Складний аналіз, де точність важливіша за швидкість |
| Batch processing | Асинхронні завдання дешевше, ніж запити в реальному часі | Нічне збагачення даних, масова класифікація, дозаповнення історичних даних |
| MCP | Стандартний спосіб дати Claude доступ до інструментів і даних | Багаторазові шари інструментів для агентів і асистентів |
| Vision і PDF | Читає зображення, скриншоти й сторінки PDF | Приймання документів, витягування даних з форм |
Набір можливостей і лімітів змінюється з кожним новим поколінням моделей Anthropic. Тому під час оцінки обсягу ми звіряємо їх з актуальною документацією API, а не покладаємося на пам'ять.
Tool use і MCP: Claude діє у ваших системах
Claude tool use інтеграція перетворює модель з генератора тексту на те, що виконує роботу. Ви описуєте набір функцій, Claude вирішує, коли і з якими аргументами їх викликати, а ваш код виконує виклик і повертає результат. До вашої бази даних модель напряму не звертається ніколи.
Інструменти ми проєктуємо як будь-який API: їх небагато, назви зрозумілі, вхідні дані типізовані, права перевіряються. Кожен виклик іде з правами поточного користувача, ризиковані дії чекають підтвердження людини, і все логується.
Коли ті самі інструменти потрібні кільком асистентам чи агентам, ми виносимо їх в MCP-сервер, а не вшиваємо в один промпт. Ми будуємо й експлуатуємо MCP-сервери в продакшені для власних систем, а наші інженери щодня працюють з ШІ-агентами на основі Claude Code. Тож поведінку Claude з реальними інструментами ми бачимо тижнями, а не лише на демо. Окремий MCP-проєкт описано на сторінці розробка MCP-серверів, багатокрокові процеси на сторінці розробка ШІ-агентів.
Що ми винесли з ШІ-продуктів у продакшені
Наш власний продукт AI Resume Master генерує резюме й супровідні листи на LLM, має імпорт із LinkedIn і вийшов на 50 000 активних користувачів на місяць.
Для американського grief-tech стартапу ми побудували AI Grief Companion: донавчання LoRA, пам'ять на RAG і шифрування під час приймання. Кожне повідомлення шифрується окремим ключем AES-256-GCM у KMS-конверті. Звідти ми винесли дві звички, які тепер переносимо в кожну інтеграцію. Промпти зберігаються в базі з історією версій і редагуються з адмін-панелі без релізу. А витрати токенів видно в тій самій адмінці поруч з користувачами, тож питання "скільки коштує цей клієнт" має відповідь.
Ви платите за кількість витрачених токенів. Це як таксі: скільки поїздок викликали, стільки й заплатили.
Антон Литвинов, засновник Lytvynov Production
Кейси
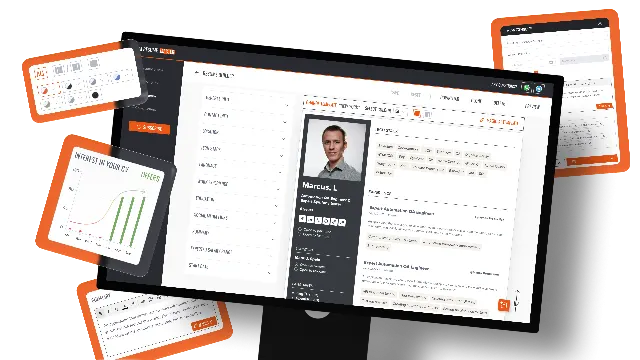
 AI Resume Master: Resume Builder with AI Integration
AI Resume Master case study: an AI resume builder with LLM writing, LinkedIn import and PDF export, built in three months and now at 50,000 monthly users. Переглянути кейс
Як не отримати несподіваний рахунок
Витрати на роботу функції складаються переважно з токенів. Тож вартість одного запиту ми рахуємо ще на етапі оцінки обсягу і проєктуємо інтеграцію так, щоб вона була низькою.
Інструкції, описи інструментів і документи, що повторюються між викликами, йдуть через кешування промптів. Прості кроки обробляє менший рівень моделі, більший вмикається лише там, де за вимірами помітно допомагає. У запит потрапляють потрібні розділи, а не все підряд, навіть якщо контекстне вікно дозволило б більше. Роботу, якій не потрібна миттєва відповідь, переводимо в пакетні завдання. А жорсткі ліміти на користувача, на функцію й на місяць не дають циклу чи стрибку трафіку обернутися рахунком, про який ви дізнаєтеся в кінці місяця.
Кожен виклик логується з кількістю токенів, і вартість видно в розрізі функцій і клієнтів.
Дані, запобіжники й перевірка якості
До API потрапляють лише поля, потрібні функції, а персональні дані маскуються, де функція це дозволяє. Фактичні відповіді беруться зі знайдених джерел і посилаються на них, докладніше про це на сторінці розробка RAG. Структуровані відповіді, які йдуть в інші системи, перевіряються за схемою і відхиляються, якщо не збігаються.
Окремо про prompt injection. Вміст від користувачів, з листів і документів ми вважаємо даними, а не інструкціями, а кожен виклик інструмента звіряємо з реальними правами доступу.
І головне: фіксований набір реальних вхідних даних з очікуваними результатами запускається при кожній зміні промпту чи моделі. Регресію видно до релізу, а не зі скарг користувачів.
Від оцінки до запуску за 4-8 тижнів
Стільки зазвичай займає перша функція на Claude в наявному продукті.
- Оцінка обсягу, 1-2 тижні. Дивимося код і дані, обираємо один вимірюваний сценарій, збираємо 30-100 реальних прикладів, тестуємо рівні Claude і одну альтернативу. Ви отримуєте фіксовану ціну й архітектурну записку.
- Прототип за feature flag, 1-2 тижні. Робоча версія на реальних даних, яку бачить ваша команда, з логуванням і обліком витрат.
- Доведення до продакшену, 1-3 тижні. Права інструментів, запобіжники, обробка помилок, потоковий інтерфейс, оцінювання в CI.
- Розгортання, 1 тиждень. Поступовий запуск, моніторинг якості й витрат, корекція промптів за реальним використанням.
Чітко окреслену першу функцію можна зробити й в одному AI Sprint: фіксовано 10 000 USD за 4 тижні.
Скільки коштує інтеграція Claude API?
Фіксовану ціну ми називаємо після оцінки обсягу. На неї впливають кількість функцій, вимоги до точності відповідей, стан ваших даних, чи потрібні Claude інструменти у ваших системах, і вимоги до безпеки. ШІ-функції для наявного продукту в нас коштують від 10 000 USD, і це ж наш мінімальний обсяг проєкту. Щомісячне використання API ви оплачуєте напряму Anthropic або своєму хмарному провайдеру, а ми оцінюємо його заздалегідь.
Чому розробку на Claude API доручають нам
Для нас розробка на Claude API не нова тема, бо ми працюємо з Claude щодня: наша власна розробка йде з ШІ-агентами на основі Claude Code під наглядом senior-інженерів. ШІ в продакшені ми теж знаємо не з презентацій, про це розділ вище. Рішення щодо моделі нейтральні: радимо Claude, коли він показує кращі результати на ваших даних, і прямо кажемо, коли ні. І працюємо у вашому стеку. Наш основний бекенд PHP і Symfony, фронтенд React або Next.js, також пишемо на Node та інших стеках.
Якщо вам потрібно найняти розробника Claude API на постійну роботу, а не на один проєкт, наші розробники Claude API можуть приєднатися до вашої команди. Інтеграція Anthropic API через Amazon Bedrock чи Vertex AI для нас така сама робота, як і напряму.
Компанію засновано у 2019 році в Дніпрі, Україна.
Наступний крок
Розкажіть, що має робити Claude і які дані йому потрібні. За 30 хвилин ми скажемо, який рівень моделі й підхід підходять, назвемо основні ризики й запропонуємо етап оцінки обсягу, що закінчується фіксованою ціною. Напишіть нам, щоб домовитися про дзвінок.
Як ми працюємо
-
Оцінка обсягу
1-2 тижні: код і дані, один сценарій, 30-100 реальних прикладів, фіксована ціна й архітектурна записка.
-
Прототип за feature flag
1-2 тижні: робоча версія на реальних даних з логуванням і обліком витрат.
-
Доведення до продакшену
1-3 тижні: права інструментів, запобіжники, обробка помилок, потоковий інтерфейс, оцінювання в CI.
-
Розгортання
1 тиждень: поступовий запуск, моніторинг якості й витрат, корекція промптів за реальним використанням.
Два способи працювати з нами
Проєкт з фіксованою ціною
Чіткий обсяг, фіксована ціна, погоджена до старту і демо щотижня. Підходить для нового продукту або зрозумілої частини роботи.
Оцінити проєктВиділена команда
Senior-інженери, які місяць за місяцем працюють лише над вашим продуктом, за вашими пріоритетами і у ваших репозиторіях.
Про виділену команду