



Що ми робимо
-
Середовища на Docker
Застосунок, воркери, база і Redis у контейнерах: розробка, staging і production працюють на тих самих образах.
-
CI/CD
Bitbucket Pipelines або GitHub Actions: збірка, тести, статичний аналіз і деплой на кожну зміну, відкат однією дією.
-
Staging і production
Окремі середовища, де в production викочується лише той образ, що пройшов staging, і лише після підтвердження.
-
Моніторинг і алерти
Логи, метрики, помилки й перевірки доступності, а алерти йдуть людям, які за них відповідають.
-
Бекапи і відновлення
Автоматичні бекапи бази й файлів, регулярні тести відновлення і записаний час відновлення для кожного продукту.
-
Kubernetes за потреби
Переводимо продукт на кластер поступово, коли це виправдовують цифри, і чесно кажемо, коли ні.
Сервер, який ніхто не хоче перезавантажувати
Знайома картина для багатьох продуктів, що виросли швидше за свою інфраструктуру. Код викочують через SSH або навіть FTP, і робить це одна людина, яка пам'ятає порядок команд. Адмінський пароль один на всіх. Бекапи колись налаштували, але ніхто ні разу не пробував з них відновитися. Staging або немає, або він живе на тому самому сервері, що й production. А про падіння сайту ви дізнаєтеся від клієнтів.
DevOps у нас означає навести в цьому лад і тримати його: як код стає робочим сервісом, як його перевіряють по дорозі, як за ним стежать у продакшені і як його відновлюють, коли щось ламається. Для продуктів, які ми створюємо самі, усе це налаштовує та сама команда, яка пише код. Тож деплой, алерти і бекапи проєктують люди, яких ці алерти будитимуть уночі.
Для наявних продуктів інших команд ми працюємо як DevOps аутсорс: ваші розробники й далі відповідають за код, а ми беремо середовища, CI/CD, моніторинг і бекапи. Починаємо з короткого аудиту, схожого за форматом на наш технічний due diligence, а після налаштування можемо лишитися на підтримці.
Чи потрібен вам Kubernetes?
На питання "чи потрібен Kubernetes" ми найчастіше відповідаємо ні, і кажемо це прямо. Вебзастосунок з базою даних, чергою і кількома воркерами добре працює на Docker Compose на одному-двох серверах або на керованому контейнерному сервісі хмарного провайдера. Kubernetes дає реальні переваги, але разом з ними кластер, який треба оновлювати, мережевий шар, у якому треба розбиратися, і більше рухомих частин для моніторингу. Для DevOps для стартапу це майже завжди зайва вага.
| Ваша ситуація | Що ми зазвичай радимо | Чому |
|---|---|---|
| Один вебзастосунок, база даних, кілька воркерів | Docker Compose або керований контейнерний сервіс | Просто, дешево, легко передати іншій команді |
| Нерівномірний трафік з помітними піками | Керовані контейнери з автомасштабуванням | Масштабування без власного кластера |
| Багато сервісів, які викочують різні команди | Kubernetes | Незалежні деплої, спільні правила платформи |
| Жорсткі вимоги до поступових оновлень і самовідновлення | Kubernetes | Вбудовані механізми викочування і перезапуску |
| Важкі GPU- або пакетні задачі | Черги задач з окремими воркерами, Kubernetes лише на масштабі | З воркерами простіше, ніж з кластером |
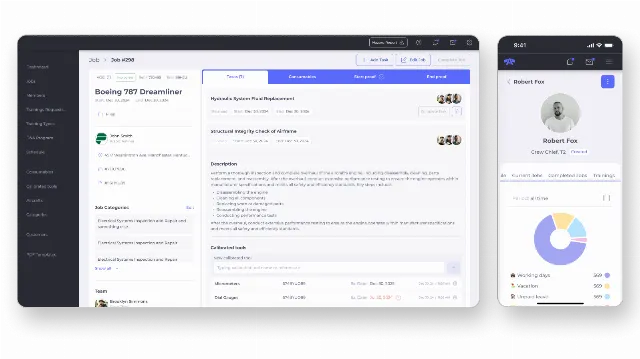
Коли продукт справді доростає до кластера, налаштування Kubernetes ми робимо поступово: спершу контейнери і CI/CD, потім кластер, потім трафік. Kubernetes у продакшені є в нашому опублікованому проєкті, ERP для американської компанії з обслуговування літаків на Symfony і React з AWS, Kubernetes і CI/CD у стеку. Один з наших сеньйорних інженерів має практичний досвід з GKE, Prometheus, Grafana і Jenkins.
Під час розробки я пропоную взяти недорогий сервер і реально порахувати, скільки ресурсів потрібно. Купувати потужності наперед у перший місяць роботи я не раджу.
Антон Литвинов, засновник Lytvynov Production
Docker з першого тижня
Docker є на кожному нашому проєкті. З першого тижня в репозиторії лежить налаштування, з яким вебзастосунок, фонові воркери, база даних і сервіси на кшталт Redis запускаються однією командою на будь-якій машині. Новий інженер працює з першого дня, а фраза "у мене локально все працює" зникає з робочих чатів.
Контейнеризація застосунку на Docker у нас іде за кількома простими правилами. Один образ на сервіс: його збирає CI і переносить зі staging у production без перезбирання, тож у production працює саме те, що пройшло перевірку. Конфігурація приходить через змінні оточення, секретів усередині образів немає. Кожен сервіс має health check, щоб платформа знала, коли контейнер готовий і коли його треба перезапустити. Образи компактні, з тим, що потрібно під час роботи, тому деплой швидший, а поверхня для атаки менша. І той самий Compose-файл описує локальний стек, тож налаштування задокументовані самим кодом.
Кілька прикладів з наших кейсів, де Docker є частиною стеку.
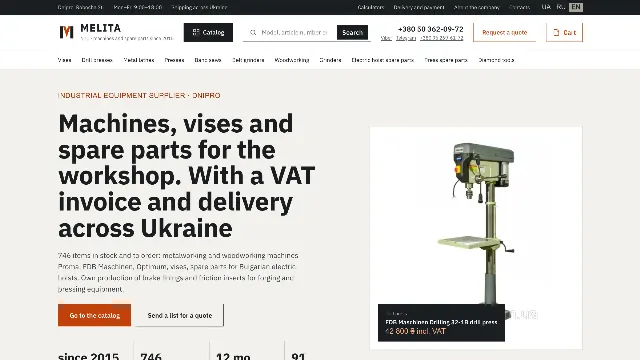
Магазин промислових верстатів для B2B-постачальника з Дніпра працює на Medusa 2, Next.js, PostgreSQL, Redis, Docker, Nginx і Cloudflare, поруч пайплайни даних на Python. Мобільні оцінки Lighthouse від 94 до 100, без зсуву макета.
Сервіс підписки на квіти для київської студії написаний на PHP 8.2, Symfony 7 і MySQL у Docker. Кожна інтеграція має sandbox-реалізацію за тим самим інтерфейсом, тож увесь процес працює локально і на демо ще до підключення справжніх ключів Telegram і Uklon.
Система керування задачами в стилі Jira для французької компанії з підтримки телеком-послуг має Docker і CI/CD у стеку та Keycloak для автентифікації і рольового доступу.
Кейси
 Industrial Machine-Tool Store: Prom.ua Migration, Trilingual Catalog, Google Shopping & AI Search
Case study: B2B machine-tool store moved from Prom.ua to its own trilingual Medusa and Next.js shop with demand-based catalog, Google Shopping feed, supplier price sync... Переглянути кейс
 AI Grief Companion: Chat History Ingestion, LoRA Persona Training & RAG Memory
Case study: AI grief companion for a US startup, with chat history ingestion, LoRA persona fine-tuning and RAG memory that keeps a loved one's voice. Переглянути кейс

Пайплайн, після якого релізи стають нудними
Добре налаштування CI/CD означає, що кожна зміна проходить ті самі кроки, ніхто не викочує з ноутбука, а відкат займає одну дію, а не вечір здогадок. На Bitbucket Pipelines чи GitHub Actions наш стандартний пайплайн виглядає так:
- Docker-образ збирається один раз на коміт.
- Проходять юніт- та інтеграційні тести, статичний аналіз і перевірка стилю коду.
- Основна гілка автоматично викочується на staging разом з міграціями бази даних.
- Staging перевіряють smoke-тести, а де це важливо, ще й людина.
- Після підтвердження в production іде той самий образ, що пройшов staging.
- Якщо щось пішло не так, повторно викочуємо попередній образ.
Для продуктів з платними клієнтами додаємо перевірку міграцій: зміна, яка заблокує велику таблицю або видалить дані, зупиниться ще до production.
Алерти, бекапи і ранбук
Моніторинг корисний, лише коли на нього хтось реагує. Тому алертів у нас небагато, і кожен означає справжню проблему: зростають помилки, сайт не відповідає, росте черга, заповнюється диск. Ці алерти йдуть людям, які за це відповідають. Дашборди потрібні для розслідування, а не для краси.
З бекапами так само. Бази даних копіюються автоматично, файли в окреме сховище, а відновлення ми регулярно перевіряємо. Бекап, з якого ніхто не відновлювався, лише надія. Для кожного продукту ми записуємо, скільки триває відновлення і скільки даних можна втратити, щоб ви знали реальні цифри до інциденту, а не під час нього.
Коли щось ламається, черговий діє за коротким письмовим ранбуком: спершу виправляє або відкочує, потім розбирається. Після інциденту коротка нотатка фіксує, що сталося і що змінюємо, щоб це не повторилося.
Інфраструктура після іншої команди
Перейняти інфраструктуру ми можемо разом з кодом або без нього. Спершу перегляд і письмовий перелік ризиків. Першими виправляємо найнебезпечніші речі, зазвичай це бекапи, доступи і деплой. Іменні акаунти замість спільного пароля, вузькі права, секрети поза репозиторієм. Лише потім переходимо до контейнерів і CI/CD.
Якщо ви оцінюєте компанію перед покупкою чи інвестицією, такий перегляд добре вписується в технічний due diligence. Якщо після переходу потрібна команда, яка продовжить розробку, ми працюємо як виділена команда розробників.
Де живуть продукти
Там, де це підходить продукту. Ми запускаємо продукти на одному VPS, коли цього досить, і на AWS, коли керовані бази даних, сховище і функції безпеки окупаються. Цю частину докладно описано на сторінці розробка на AWS.
У ШІ-продуктах GPU-обчислення часто живуть окремо від основного хостингу. Так зроблено в AI Grief Companion: воркери Celery розділяють ETL на CPU і навчання на GPU, основну роботу виконує власний GPU-сервер команди, а serverless-образи RunPod підхоплюють навчання, інференс і розпізнавання фото, коли його вже не вистачає.
Прикладна частина пишеться на нашому звичайному стеку: PHP і Symfony для продуктів зі складною бізнес-логікою, Node.js для продуктів повністю на JavaScript, Python для ШІ-сервісів і роботи з даними, React, Next.js і React Native на фронтенді. Для повноцінного SaaS-продукту Docker і Kubernetes налаштування, CI/CD і моніторинг закладаємо з першого етапу, а не доробляємо перед запуском.
Скільки коштує DevOps-робота?
DevOps у нас є частиною роботи над продуктом, тому його вартість рахується разом з розробкою або з переходом продукту до нас на підтримку. Мінімальний обсяг проєкту становить 10 000 USD. Хостинг і хмарні сервіси ви оплачуєте напряму провайдерам зі своїх акаунтів. Після короткої розмови для оцінки обсягу ми даємо фіксовану ціну на перший етап.
Як ми працюємо
Спершу коротка розмова про продукт, про те, як його викочують зараз, і що вас найбільше турбує. Для наявного продукту першим етапом стає перегляд з письмовим звітом і планом, для нового налаштування постачання входить у перший етап. Усе зберігається у ваших репозиторіях і акаунтах: Dockerfile, пайплайни та інфраструктурний код переглядають як будь-який інший код, а повний доступ лишається у вас. Сеньйорні інженери переглядають кожну зміну, а ШІ-агенти для написання коду беруть на себе рутину на кшталт оновлення пайплайнів і тестів.
Розкажіть про свій продукт на сторінці контактів або опишіть обсяг у формі оцінки проєкту.
Як ми працюємо
-
Коротка розмова
Про продукт, як його викочують зараз і що вас найбільше турбує.
-
Аудит або перший етап
Для наявного продукту перегляд з письмовим звітом і планом, для нового налаштування входить у перший етап.
-
Фіксована ціна
Після оцінки обсягу ви отримуєте фіксовану ціну на перший етап.
-
Усе у ваших акаунтах
Dockerfile, пайплайни й інфраструктурний код лежать у ваших репозиторіях, повний доступ лишається у вас.
Два способи працювати з нами
Проєкт з фіксованою ціною
Чіткий обсяг, фіксована ціна, погоджена до старту і демо щотижня. Підходить для нового продукту або зрозумілої частини роботи.
Оцінити проєктВиділена команда
Senior-інженери, які місяць за місяцем працюють лише над вашим продуктом, за вашими пріоритетами і у ваших репозиторіях.
Про виділену команду