Fr
 En
 De
 It
 Es
 Uk
Que comprennent nos services de développement Python ?
Nos services de développement Python se concentrent sur l'IA et les données : services FastAPI autour des modèles de langage, pipelines d'ingestion qui transforment des sources désordonnées en données propres, génération augmentée par recherche (RAG) et fine-tuning de modèles avec des workers en arrière-plan. Nos produits web sont généralement construits sur PHP/Symfony ou Node.js avec React ; Python est le langage que nous ajoutons là où le travail d'IA et de données l'exige.
Une mission Python type comprend :
- Services FastAPI qui encapsulent les appels aux modèles, la recherche documentaire et la logique métier derrière une API typée que votre produit peut appeler.
- Intégration de LLM avec OpenAI, Anthropic Claude ou des modèles ouverts, y compris la gestion des prompts et des jeux d'évaluation.
- RAG : ingestion de documents, découpage, embeddings, recherche vectorielle et par graphe, avec des contrôles de permissions.
- Pipelines de données : parseurs pour de nombreux formats sources, normalisation, déduplication et synchronisations planifiées.
- Fine-tuning et inférence : adaptateurs LoRA sur des modèles ouverts, workers GPU et mise à disposition des modèles.
- Traitements en arrière-plan avec files de tâches, relances et statut visible pour les travaux longs.
Quand utiliser Python dans votre produit ?
Utilisez Python lorsque le travail relève de l'IA, du machine learning ou du traitement de données lourd, car c'est là que son écosystème est le plus fort. Pour le reste du produit, comme les comptes, la facturation, l'administration et les règles métier, un back-end PHP ou Node.js est souvent mieux adapté, et beaucoup de nos produits utilisent les deux.
| Tâche | Où nous la développons habituellement | Pourquoi |
|---|---|---|
| Appeler OpenAI ou Claude, diffuser les réponses en streaming | Votre back-end existant (PHP ou Node.js) | Pas besoin d'un nouveau service |
| Ingérer et normaliser de nombreux formats de documents ou de données | Service Python | Bibliothèques de parsing et de données matures |
| RAG sur des données volumineuses ou qui changent souvent | Service Python | Outillage d'embedding, de recherche et d'évaluation |
| Fine-tuning, entraînement LoRA, inférence de modèles ouverts | Python avec workers GPU | L'écosystème ML vit en Python |
| Comptes, facturation, rôles, back-offices | PHP/Symfony ou Node.js | Outillage produit et back-office mature |
Notre propre produit AI Resume Master suit cette répartition : PHP et Symfony pour le produit, React pour l'interface, Python pour la génération de CV et de lettres de motivation par IA. Il a atteint 50 000 utilisateurs actifs mensuels.
Comment construisez-vous des services d'IA avec FastAPI ?
Un service d'IA sous FastAPI est une petite API typée qui cache les appels aux modèles, la recherche documentaire et la logique des prompts au reste du produit. Le produit pose une question ou soumet une tâche ; le service décide quel modèle et quelles données utiliser et renvoie un résultat dans un format fixe.
Nos choix par défaut :
- Contrats typés pour chaque requête et chaque réponse, avec une documentation OpenAPI générée à partir d'eux.
- Prompts stockés comme des données, versionnés et modifiables sans mise en production lorsque le produit en a besoin.
- Des tâches, pas des requêtes longues : tout ce qui prend plus de quelques secondes tourne dans des workers en arrière-plan, avec un statut que le produit peut interroger ou recevoir par callback.
- Modèles de repli et timeouts, pour qu'un fournisseur lent ne bloque pas le produit.
- Jeux d'évaluation vérifiés en CI, pour qu'un changement de prompt ou de modèle soit mesuré avant sa mise en production.
- Journalisation des entrées, des sorties et de la consommation de tokens, avec un traitement des données sensibles conforme à vos règles.
Dans l'AI Grief Companion développé pour une startup américaine, la plateforme IA tourne sur Python, FastAPI et Celery avec PostgreSQL, Redis et Neo4j. Chaque étape d'entraînement est un contrat typé qui produit des artefacts pour la suivante, et la fin du traitement remonte par callback via la passerelle jusqu'à l'API du produit.
Comment construisez-vous des pipelines de données et du RAG ?
Un bon RAG commence par une bonne ingestion. La plupart des problèmes de recherche viennent de données qui n'ont jamais été nettoyées : doublons, mise en forme cassée, propriétaires manquants et langues mélangées. Nous construisons le pipeline d'abord, le chat ensuite.
Le pipeline : un parseur par format source ; une normalisation vers un schéma unique ; la déduplication et la validation ; un découpage qui suit la structure des documents ; les embeddings et un index ; puis la recherche avec des contrôles d'accès pour que chaque utilisateur ne voie que ce qu'il a le droit de voir. Chaque étape journalise ce qu'elle a traité et ce qui a échoué. Notre page développement RAG et notre guide de mise en œuvre du RAG vont plus loin.
Deux exemples publiés de cette rigueur :
- Dans l'AI Grief Companion, une passerelle Python analyse dix formats d'export de conversations (WhatsApp, Messenger, Instagram, Discord, iMessage depuis une sauvegarde d'iPhone, SMS Android et d'autres) vers une table de messages normalisée unique et chiffre chaque message dès l'ingestion. La mémoire repose sur trois couches de recherche au-dessus d'un graphe de faits Neo4j.
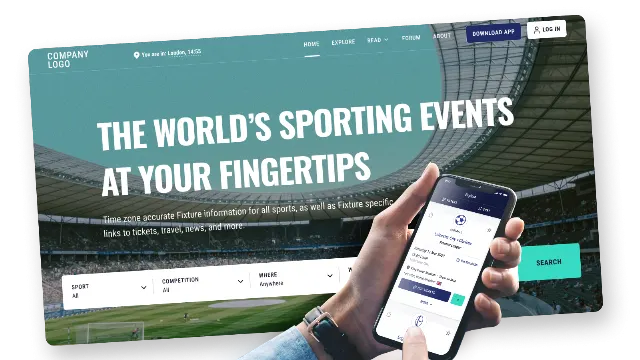
- Le calendrier d'événements sportifs développé avec PHP et Python pour une entreprise sport tech basée au Royaume-Uni dispose d'un moteur de parsing sur mesure qui agrège et normalise les rencontres de centaines de calendriers et de flux, avec la gestion des fuseaux horaires, des API et des widgets intégrables pour des clients B2B.
Quand le fine-tuning a-t-il du sens ?
Le fine-tuning a du sens lorsqu'un modèle doit tenir un ton, un format ou un comportement précis que les prompts et le RAG ne parviennent pas à maintenir de façon fiable. Pour la plupart des produits métier, des prompts combinés à une recherche sur vos propres données vont plus loin, coûtent moins cher et sont plus faciles à mettre à jour lorsque les données changent.
Lorsque le fine-tuning est le bon choix, nous utilisons des méthodes économes en paramètres comme LoRA sur un modèle ouvert, avec un jeu de données construit à partir de vos données et un jeu d'évaluation pour mesurer le résultat. Dans l'AI Grief Companion, le pipeline construit un jeu de données, entraîne des adaptateurs LoRA sur Qwen2.5-7B en QLoRA 4 bits, et vLLM charge le bon adaptateur à chaque requête. L'inférence se dégrade volontairement : le chat fonctionne avec le modèle de base quelques minutes après l'import et se rapproche de la personne à mesure que chaque étape d'entraînement se termine. Pour en savoir plus sur le choix des modèles, consultez notre page développement IA générative.
Pouvez-vous ajouter un service Python à un produit PHP ou Node.js existant ?
Oui, et c'est la façon la plus courante dont nous utilisons Python. Votre produit conserve son back-end, ses comptes et sa facturation ; un service Python séparé prend en charge le travail d'IA ou de données et expose une petite API typée. Le back-end principal l'appelle avec le contexte de l'utilisateur, et les tâches longues rendent compte par callback ou via un endpoint de statut. Les permissions restent dans le back-end principal : le service Python ne décide jamais seul qui peut voir quoi.
Le risque reste ainsi faible : le nouveau service peut être déployé, dimensionné et annulé indépendamment, et le reste du produit ne change ni de langage ni de framework. Consultez développement PHP et développement Node.js pour l'autre côté de l'intégration.
Combien coûte le développement Python ?
Le coût du développement Python dépend du volume de données, de la stratégie de modèles et de la façon dont le service se connecte à votre produit. À titre indicatif, chez nous, une fonctionnalité IA sur des modèles hébergés commence à 10 000 USD, une application IA sur les données de l'entreprise avec RAG coûte de 10 000 à 40 000 USD, et un produit avec des modèles sur mesure (fine-tuning, mémoire RAG, inférence sur GPU, pipelines de données) se situe entre 60 000 et 150 000 USD. Les coûts de fonctionnement en tokens, bases vectorielles et GPU s'y ajoutent.
Comment nous travaillons sur les projets Python
Nous commençons par un court appel sur le produit, les données et ce que l'IA doit faire, puis nous convenons du premier jalon avec un devis ferme. Pour le travail d'IA, le premier jalon comprend généralement un jeu d'évaluation, pour que la qualité soit mesurée dès la première semaine. La livraison se fait par jalons avec des démos hebdomadaires, dans vos dépôts et vos comptes cloud. Des ingénieurs seniors relisent chaque modification, et des agents de codage IA prennent en charge le travail de routine comme les tests et les refactorings. Pour connecter l'IA à un produit existant, consultez intégration IA.
Parlez-nous de votre projet IA ou data via notre page contact, ou décrivez le périmètre dans notre formulaire d'estimation de projet.