




Что мы делаем
-
Сервисы на FastAPI
Типизированный API, за которым спрятаны вызовы моделей, поиск и логика промптов. Ваш продукт просто его вызывает.
-
Конвейеры данных
Парсер на каждый формат источника, нормализация в одну схему, дедупликация и лог каждой записи, которая не прошла.
-
RAG
Разбиение на фрагменты, эмбеддинги, векторный и графовый поиск с проверкой прав доступа.
-
Интеграция LLM
OpenAI, Anthropic Claude или открытые модели, с версиями промптов, резервными моделями и наборами для оценки.
-
Дообучение и инференс
LoRA-адаптеры на открытых моделях, GPU-воркеры и vLLM, который подгружает нужный адаптер под запрос.
-
Фоновая обработка
Очереди задач, повторные попытки и видимый статус для всего, что длится дольше нескольких секунд.
Двадцать минут между файлом и живым разговором
Человек загружает экспорт WhatsApp или резервную копию iPhone и ждет примерно двадцать минут. За это время система разбирает переписку, выясняет, кто из двух участников тот человек, которого помнят, пишет его профиль от первого лица, собирает набор данных, обучает адаптер и строит граф фактов. Так работает AI Grief Companion, который мы сделали для американского стартапа. Вся эта часть написана на Python.
Шлюз на Python разбирает десять форматов экспорта: WhatsApp, Messenger, Instagram, Discord, iMessage из резервной копии iPhone, Android SMS и обычный текст. Все сводится в одну таблицу сообщений, и каждое сообщение шифруется сразу при загрузке. Если детектор ролей не уверен, кто есть кто, он останавливается и спрашивает пользователя, а не угадывает: ошибка здесь означала бы модель, обученную на чужих словах. ИИ-платформа над шлюзом работает на FastAPI и Celery с PostgreSQL, Redis и Neo4j. Семь типов задач расходятся между CPU- и GPU-воркерами, а когда собственного GPU-сервера не хватает, обучение и инференс берут serverless-воркеры RunPod.
Такая разработка ИИ на Python и есть наша основная работа с этим языком: сервисы на FastAPI вокруг языковых моделей, конвейеры, которые превращают беспорядочные источники в чистые данные, RAG и дообучение с фоновыми воркерами.
Кейсы
 AI Resume Master: Resume Builder with AI Integration
AI Resume Master case study: an AI resume builder with LLM writing, LinkedIn import and PDF export, built in three months and now at 50,000 monthly users. Смотреть кейс
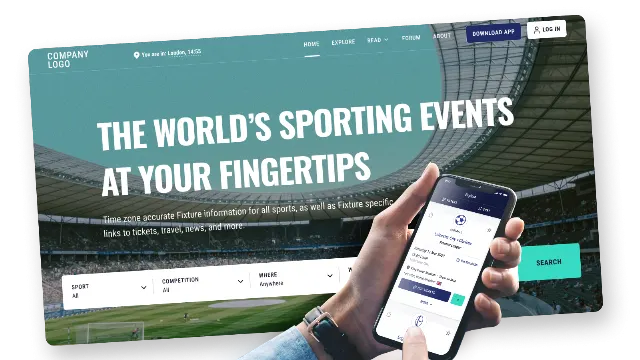
 Smart Sports Event Discovery Platform
Case study: sports event calendar for a UK company that aggregates fixtures from hundreds of calendars and feeds, with APIs and embeddable widgets. Смотреть кейс
Python для ИИ и данных, остальной продукт на своем месте
Веб-продукты мы обычно строим на PHP/Symfony или Node.js с React. Python добавляем туда, где этого требует работа с ИИ, машинным обучением или большими объемами данных, потому что именно там его экосистема сильнее всего. Учетные записи, оплаты, админка и бизнес-правила часто лучше чувствуют себя в основном бэкенде, и многие наши продукты используют оба языка.
| Задача | Где мы обычно ее реализуем | Почему |
|---|---|---|
| Вызовы OpenAI или Claude, потоковая передача ответов | Ваш существующий бэкенд (PHP или Node.js) | Новый сервис не нужен |
| Загрузка и нормализация многих форматов документов или данных | Python-сервис | Зрелые библиотеки для парсинга и работы с данными |
| RAG над большими или часто меняющимися данными | Python-сервис | Инструменты для эмбеддингов, поиска и оценки |
| Дообучение, обучение LoRA, инференс открытых моделей | Python с GPU-воркерами | Экосистема ML живет в Python |
| Учетные записи, оплаты, роли, админ-панели | PHP/Symfony или Node.js | Зрелые инструменты для продукта и админки |
Именно по такому разделению сделан наш собственный AI Resume Master: PHP и Symfony держат продукт, React отвечает за интерфейс, Python с LLM генерирует резюме и сопроводительные письма. Продукт вышел на 50 000 активных пользователей в месяц.
Можно ли добавить Python-сервис к продукту на PHP или Node.js?
Да, и именно так мы чаще всего используем Python. Ваш продукт сохраняет свой бэкенд, учетные записи и оплаты. Отдельный Python-сервис занимается ИИ или данными и предоставляет небольшой типизированный API. Основной бэкенд вызывает его с контекстом пользователя, а длительные задачи отчитываются через колбэк или эндпоинт статуса. Права доступа остаются в основном бэкенде, так что Python-сервис сам никогда не решает, кто что видит.
Риск при этом низкий. Новый сервис разворачивается, масштабируется и откатывается отдельно, а остальной продукт не меняет ни язык, ни фреймворк. Другая сторона интеграции описана на страницах разработка на PHP и разработка на Node.js.
Сервис на FastAPI: наши правила
Разработка на FastAPI у нас дает небольшой типизированный API, который прячет от остального продукта вызовы моделей, поиск и логику промптов. Продукт задает вопрос или отправляет задачу. Сервис сам решает, какую модель и какие данные взять, и возвращает результат в фиксированном формате. Мы держимся шести правил:
- Типизированные контракты для каждого запроса и ответа, документация OpenAPI генерируется из них.
- Промпты хранятся как данные, с версиями. В AI Grief Companion они лежат в PostgreSQL с историей изменений, и тон можно подправить из админки без релиза.
- Задачи вместо долгих запросов. Все, что длится дольше нескольких секунд, уходит в фоновые воркеры со статусом, который продукт опрашивает или получает через колбэк.
- Резервные модели и тайм-ауты, чтобы один медленный провайдер не останавливал продукт.
- Наборы для оценки в CI: изменение промпта или модели измеряем до релиза.
- Логи входных данных, результатов и расхода токенов. С чувствительными данными работаем по вашим правилам.
Сначала чистые данные, потом чат
Большинство проблем с поиском возникает из-за данных, которые никто не чистил: дубликаты, сломанное форматирование, отсутствующие владельцы, смешанные языки. Поэтому разработка RAG на Python у нас начинается с конвейера, а чат появляется позже.
Конвейер состоит из парсера на каждый формат источника, нормализации в одну схему, дедупликации и валидации. Дальше разбиение на фрагменты по структуре документа, эмбеддинги и индекс, а в конце поиск с проверкой доступа, чтобы пользователь видел только разрешенное. Каждый шаг пишет в лог, что он обработал и что не удалось. В AI Grief Companion память строят три уровня поиска над графом фактов в Neo4j, и они соревнуются за пять мест в промпте. Подробнее на странице разработка RAG и в нашем руководстве по внедрению RAG.
Разработка конвейеров данных нужна не только для ИИ. Календарь спортивных событий для британской sports tech компании построен на PHP и Python и имеет собственный движок парсинга. Он собирает и нормализует расписания матчей из сотен календарей и фидов, учитывает часовые пояса и отдает данные B2B-клиентам через API и встраиваемые виджеты. А для B2B-магазина станков из Днепра Python обрабатывал данные каталога и убирал водяные знаки со старых фото товаров для фида Google Shopping.
Когда дообучение имеет смысл?
Когда модель должна держать определенный голос, формат или поведение, которые промпты и RAG надежно не удерживают. Для большинства бизнес-продуктов промпты плюс поиск по вашим данным дают больше, стоят меньше и проще обновляются, когда данные меняются.
Если дообучение все же нужно, берем параметрически эффективные методы вроде LoRA на открытой модели, набор данных из ваших данных и набор для оценки, чтобы измерить результат. В AI Grief Companion конвейер обучает LoRA-адаптеры на Qwen2.5-7B с 4-битным QLoRA, а vLLM для каждого запроса подгружает нужный адаптер. У инференса намеренно есть запасной режим: чат работает с базовой моделью уже через несколько минут после загрузки и становится ближе к человеку с каждым завершенным этапом обучения. О выборе моделей читайте на странице разработка генеративного ИИ.
Если мы хотим, чтобы бот действительно общался с людьми, ему нужно дать базу знаний о вашей компании. Это не сложно, ее просто нужно подготовить, а дальше пополнять в автоматическом режиме.
Антон Литвинов, основатель Lytvynov Production
Сколько стоит разработка на Python?
Цена зависит от объема данных, стратегии по моделям и того, как сервис подключается к вашему продукту. Для ориентира: ИИ-функция на облачных моделях у нас стоит от 10 000 USD, ИИ-приложение над данными компании с RAG от 10 000 до 40 000 USD, продукт с собственными моделями (дообучение, RAG-память, инференс на GPU, конвейеры данных) от 60 000 до 150 000 USD. Токены, векторные хранилища и GPU во время работы оплачиваются отдельно. Как их посчитать, объясняем в руководстве о стоимости разработки ИИ-приложения.
Как мы работаем
Как компания по разработке на Python мы начинаем с короткого разговора о продукте, данных и том, что должен делать ИИ, а потом согласуем первый этап с фиксированной ценой. Для ИИ-проектов он обычно включает набор для оценки, так что качество измеряется с первой недели. Дальше этапы с демо каждую неделю, в ваших репозиториях и облачных аккаунтах. Наши Python-разработчики уровня senior проверяют каждое изменение, а рутину вроде тестов и рефакторинга берут ИИ-агенты для написания кода. Хотите нанять Python разработчиков в свою команду на более долгий срок? Это тоже возможно, с помесячной оплатой.
Подключение ИИ к существующему продукту описано на странице интеграция ИИ. Развертывание и мониторинг Python-сервисов берем на себя, подробнее на страницах DevOps на Docker и Kubernetes и разработка на AWS.
Расскажите о вашем ИИ-проекте или проекте с данными на странице контактов или опишите объем в форме оценки проекта.
Как мы работаем
-
Короткий разговор
Говорим о продукте, данных и том, что должен делать ИИ.
-
Фиксированная цена этапа
Согласуем первый этап с фиксированной ценой. Для ИИ-проектов он включает набор для оценки.
-
Демо каждую неделю
Работа идет этапами в ваших репозиториях и облачных аккаунтах.
-
Проверка senior-инженером
Senior-инженеры проверяют каждое изменение, ИИ-агенты берут рутину: тесты и рефакторинг.
-
Развертывание
Python-сервис разворачивается, масштабируется и откатывается отдельно от остального продукта.
Два способа работать с нами
Проект с фиксированной ценой
Четкий объем, фиксированная цена, согласованная до старта и демо каждую неделю. Подходит для нового продукта или понятной части работы.
Оценить проектВыделенная команда
Senior-инженеры, которые месяц за месяцем работают только над вашим продуктом, по вашим приоритетам и в ваших репозиториях.
О выделенной команде