




Что мы делаем
-
Окружения на Docker
Приложение, воркеры, база и Redis в контейнерах: разработка, staging и production работают на одних и тех же образах.
-
CI/CD
Bitbucket Pipelines или GitHub Actions: сборка, тесты, статический анализ и деплой на каждое изменение, откат одним действием.
-
Staging и production
Отдельные окружения, где в production выкатывается только тот образ, который прошел staging, и только после подтверждения.
-
Мониторинг и алерты
Логи, метрики, ошибки и проверки доступности, а алерты идут людям, которые за них отвечают.
-
Бэкапы и восстановление
Автоматические бэкапы базы и файлов, регулярные тесты восстановления и записанное время восстановления для каждого продукта.
-
Kubernetes при необходимости
Переводим продукт на кластер постепенно, когда это оправдывают цифры, и честно говорим, когда нет.
Сервер, который никто не хочет перезагружать
Знакомая картина для многих продуктов, которые выросли быстрее своей инфраструктуры. Код выкатывают через SSH или даже FTP, и делает это один человек, который помнит порядок команд. Админский пароль один на всех. Бэкапы когда-то настроили, но никто ни разу не пробовал из них восстановиться. Staging либо нет, либо он живет на том же сервере, что и production. А о падении сайта вы узнаете от клиентов.
DevOps у нас означает навести в этом порядок и держать его: как код становится рабочим сервисом, как его проверяют по дороге, как за ним следят в продакшене и как его восстанавливают, когда что-то ломается. Для продуктов, которые мы создаем сами, все это настраивает та же команда, которая пишет код. Поэтому деплой, алерты и бэкапы проектируют люди, которых эти алерты будут будить ночью.
Для существующих продуктов других команд мы работаем как DevOps аутсорс: ваши разработчики продолжают отвечать за код, а мы берем окружения, CI/CD, мониторинг и бэкапы. Начинаем с короткого аудита, похожего по формату на наш технический due diligence, а после настройки можем остаться на поддержке.
Нужен ли вам Kubernetes?
На вопрос «нужен ли Kubernetes» мы чаще всего отвечаем нет, и говорим это прямо. Веб-приложение с базой данных, очередью и несколькими воркерами хорошо работает на Docker Compose на одном-двух серверах или на управляемом контейнерном сервисе облачного провайдера. Kubernetes дает реальные преимущества, но вместе с ними кластер, который нужно обновлять, сетевой слой, в котором нужно разбираться, и больше движущихся частей для мониторинга. Для DevOps для стартапа это почти всегда лишний вес.
| Ваша ситуация | Что мы обычно советуем | Почему |
|---|---|---|
| Одно веб-приложение, база данных, несколько воркеров | Docker Compose или управляемый контейнерный сервис | Просто, дешево, легко передать другой команде |
| Неравномерный трафик с заметными пиками | Управляемые контейнеры с автомасштабированием | Масштабирование без собственного кластера |
| Много сервисов, которые выкатывают разные команды | Kubernetes | Независимые деплои, общие правила платформы |
| Жесткие требования к постепенным обновлениям и самовосстановлению | Kubernetes | Встроенные механизмы выкатки и перезапуска |
| Тяжелые GPU- или пакетные задачи | Очереди задач с отдельными воркерами, Kubernetes только на масштабе | С воркерами проще, чем с кластером |
Когда продукт действительно дорастает до кластера, настройку Kubernetes мы делаем постепенно: сначала контейнеры и CI/CD, потом кластер, потом трафик. Kubernetes в продакшене есть в нашем опубликованном проекте, ERP для американской компании по обслуживанию самолетов на Symfony и React с AWS, Kubernetes и CI/CD в стеке. У одного из наших senior-инженеров есть практический опыт с GKE, Prometheus, Grafana и Jenkins.
Во время разработки я предлагаю взять недорогой сервер и реально посчитать, сколько ресурсов нужно. Покупать мощности наперед в первый месяц работы я не советую.
Антон Литвинов, основатель Lytvynov Production
Docker с первой недели
Docker есть на каждом нашем проекте. С первой недели в репозитории лежит настройка, с которой веб-приложение, фоновые воркеры, база данных и сервисы вроде Redis запускаются одной командой на любой машине. Новый инженер работает с первого дня, а фраза «у меня локально все работает» исчезает из рабочих чатов.
Контейнеризация приложения на Docker у нас идет по нескольким простым правилам. Один образ на сервис: его собирает CI и переносит со staging в production без пересборки, поэтому в production работает именно то, что прошло проверку. Конфигурация приходит через переменные окружения, секретов внутри образов нет. У каждого сервиса есть health check, чтобы платформа знала, когда контейнер готов и когда его нужно перезапустить. Образы компактные, только с тем, что нужно во время работы, поэтому деплой быстрее, а поверхность для атаки меньше. И тот же Compose-файл описывает локальный стек, так что настройки задокументированы самим кодом.
Несколько примеров из наших кейсов, где Docker входит в стек.
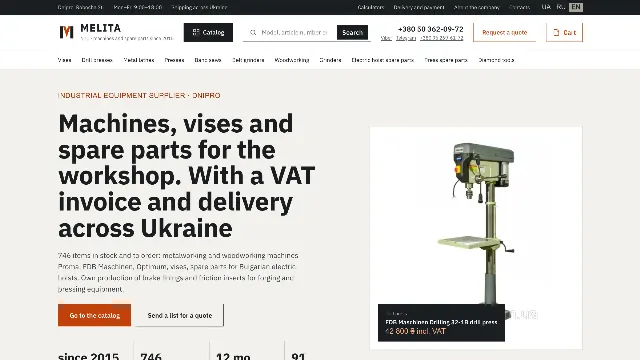
Магазин промышленных станков для B2B-поставщика из Днепра работает на Medusa 2, Next.js, PostgreSQL, Redis, Docker, Nginx и Cloudflare, рядом пайплайны данных на Python. Мобильные оценки Lighthouse от 94 до 100, без сдвига макета.
Сервис подписки на цветы для киевской студии написан на PHP 8.2, Symfony 7 и MySQL в Docker. У каждой интеграции есть sandbox-реализация за тем же интерфейсом, поэтому весь процесс работает локально и на демо еще до подключения настоящих ключей Telegram и Uklon.
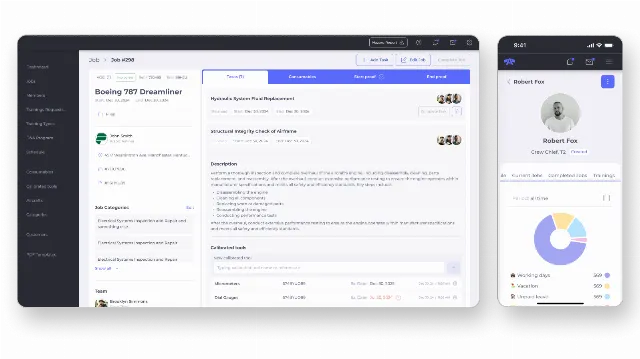
Система управления задачами в стиле Jira для французской компании по поддержке телеком-услуг имеет Docker и CI/CD в стеке и Keycloak для аутентификации и ролевого доступа.
Кейсы
 Industrial Machine-Tool Store: Prom.ua Migration, Trilingual Catalog, Google Shopping & AI Search
Case study: B2B machine-tool store moved from Prom.ua to its own trilingual Medusa and Next.js shop with demand-based catalog, Google Shopping feed, supplier price sync... Смотреть кейс
 AI Grief Companion: Chat History Ingestion, LoRA Persona Training & RAG Memory
Case study: AI grief companion for a US startup, with chat history ingestion, LoRA persona fine-tuning and RAG memory that keeps a loved one's voice. Смотреть кейс

Пайплайн, после которого релизы становятся скучными
Хорошая настройка CI/CD означает, что каждое изменение проходит одни и те же шаги, никто не выкатывает с ноутбука, а откат занимает одно действие, а не вечер догадок. На Bitbucket Pipelines или GitHub Actions наш стандартный пайплайн выглядит так:
- Docker-образ собирается один раз на коммит.
- Проходят юнит- и интеграционные тесты, статический анализ и проверка стиля кода.
- Основная ветка автоматически выкатывается на staging вместе с миграциями базы данных.
- Staging проверяют smoke-тесты, а где это важно, еще и человек.
- После подтверждения в production идет тот же образ, который прошел staging.
- Если что-то пошло не так, повторно выкатываем предыдущий образ.
Для продуктов с платящими клиентами добавляем проверку миграций: изменение, которое заблокирует большую таблицу или удалит данные, остановится еще до production.
Алерты, бэкапы и ранбук
Мониторинг полезен, только когда на него кто-то реагирует. Поэтому алертов у нас немного, и каждый означает настоящую проблему: растут ошибки, сайт не отвечает, растет очередь, заполняется диск. Эти алерты идут людям, которые за это отвечают. Дашборды нужны для расследования, а не для красоты.
С бэкапами так же. Базы данных копируются автоматически, файлы в отдельное хранилище, а восстановление мы регулярно проверяем. Бэкап, из которого никто не восстанавливался, это только надежда. Для каждого продукта мы записываем, сколько длится восстановление и сколько данных можно потерять, чтобы вы знали реальные цифры до инцидента, а не во время него.
Когда что-то ломается, дежурный действует по короткому письменному ранбуку: сначала исправляет или откатывает, потом разбирается. После инцидента короткая заметка фиксирует, что произошло и что меняем, чтобы это не повторилось.
Инфраструктура после другой команды
Принять инфраструктуру мы можем вместе с кодом или без него. Сначала обзор и письменный перечень рисков. Первыми исправляем самые опасные вещи, обычно это бэкапы, доступы и деплой. Именные аккаунты вместо общего пароля, узкие права, секреты вне репозитория. Только потом переходим к контейнерам и CI/CD.
Если вы оцениваете компанию перед покупкой или инвестицией, такой обзор хорошо вписывается в технический due diligence. Если после перехода нужна команда, которая продолжит разработку, мы работаем как выделенная команда разработчиков.
Где живут продукты
Там, где это подходит продукту. Мы запускаем продукты на одном VPS, когда этого достаточно, и на AWS, когда управляемые базы данных, хранилище и функции безопасности окупаются. Эта часть подробно описана на странице разработка на AWS.
В ИИ-продуктах GPU-вычисления часто живут отдельно от основного хостинга. Так сделано в AI Grief Companion: воркеры Celery разделяют ETL на CPU и обучение на GPU, основную работу выполняет собственный GPU-сервер команды, а serverless-образы RunPod подхватывают обучение, инференс и распознавание фото, когда его уже не хватает.
Прикладная часть пишется на нашем обычном стеке: PHP и Symfony для продуктов со сложной бизнес-логикой, Node.js для продуктов полностью на JavaScript, Python для ИИ-сервисов и работы с данными, React, Next.js и React Native на фронтенде. Для полноценного SaaS-продукта настройку Docker и Kubernetes, CI/CD и мониторинг закладываем с первого этапа, а не доделываем перед запуском.
Сколько стоит DevOps-работа?
DevOps у нас часть работы над продуктом, поэтому его стоимость считается вместе с разработкой или с переходом продукта к нам на поддержку. Минимальный объем проекта 10 000 USD. Хостинг и облачные сервисы вы оплачиваете напрямую провайдерам со своих аккаунтов. После короткого разговора для оценки объема мы даем фиксированную цену на первый этап.
Как мы работаем
Сначала короткий разговор о продукте, о том, как его выкатывают сейчас, и что вас больше всего беспокоит. Для существующего продукта первым этапом становится обзор с письменным отчетом и планом, для нового настройка поставки входит в первый этап. Все хранится в ваших репозиториях и аккаунтах: Dockerfile, пайплайны и инфраструктурный код просматривают как любой другой код, а полный доступ остается у вас. Senior-инженеры просматривают каждое изменение, а ИИ-агенты для написания кода берут на себя рутину вроде обновления пайплайнов и тестов.
Расскажите о своем продукте на странице контактов или опишите объем в форме оценки проекта.
Как мы работаем
-
Короткий разговор
О продукте, как его выкатывают сейчас и что вас больше всего беспокоит.
-
Аудит или первый этап
Для существующего продукта обзор с письменным отчетом и планом, для нового настройка входит в первый этап.
-
Фиксированная цена
После оценки объема вы получаете фиксированную цену на первый этап.
-
Все в ваших аккаунтах
Dockerfile, пайплайны и инфраструктурный код лежат в ваших репозиториях, полный доступ остается у вас.
Два способа работать с нами
Проект с фиксированной ценой
Четкий объем, фиксированная цена, согласованная до старта и демо каждую неделю. Подходит для нового продукта или понятной части работы.
Оценить проектВыделенная команда
Senior-инженеры, которые месяц за месяцем работают только над вашим продуктом, по вашим приоритетам и в ваших репозиториях.
О выделенной команде